ClaudeCode中的cd死循环与自纠错陷阱
2026年5月11日 · AI 基础设施 · 9 min read
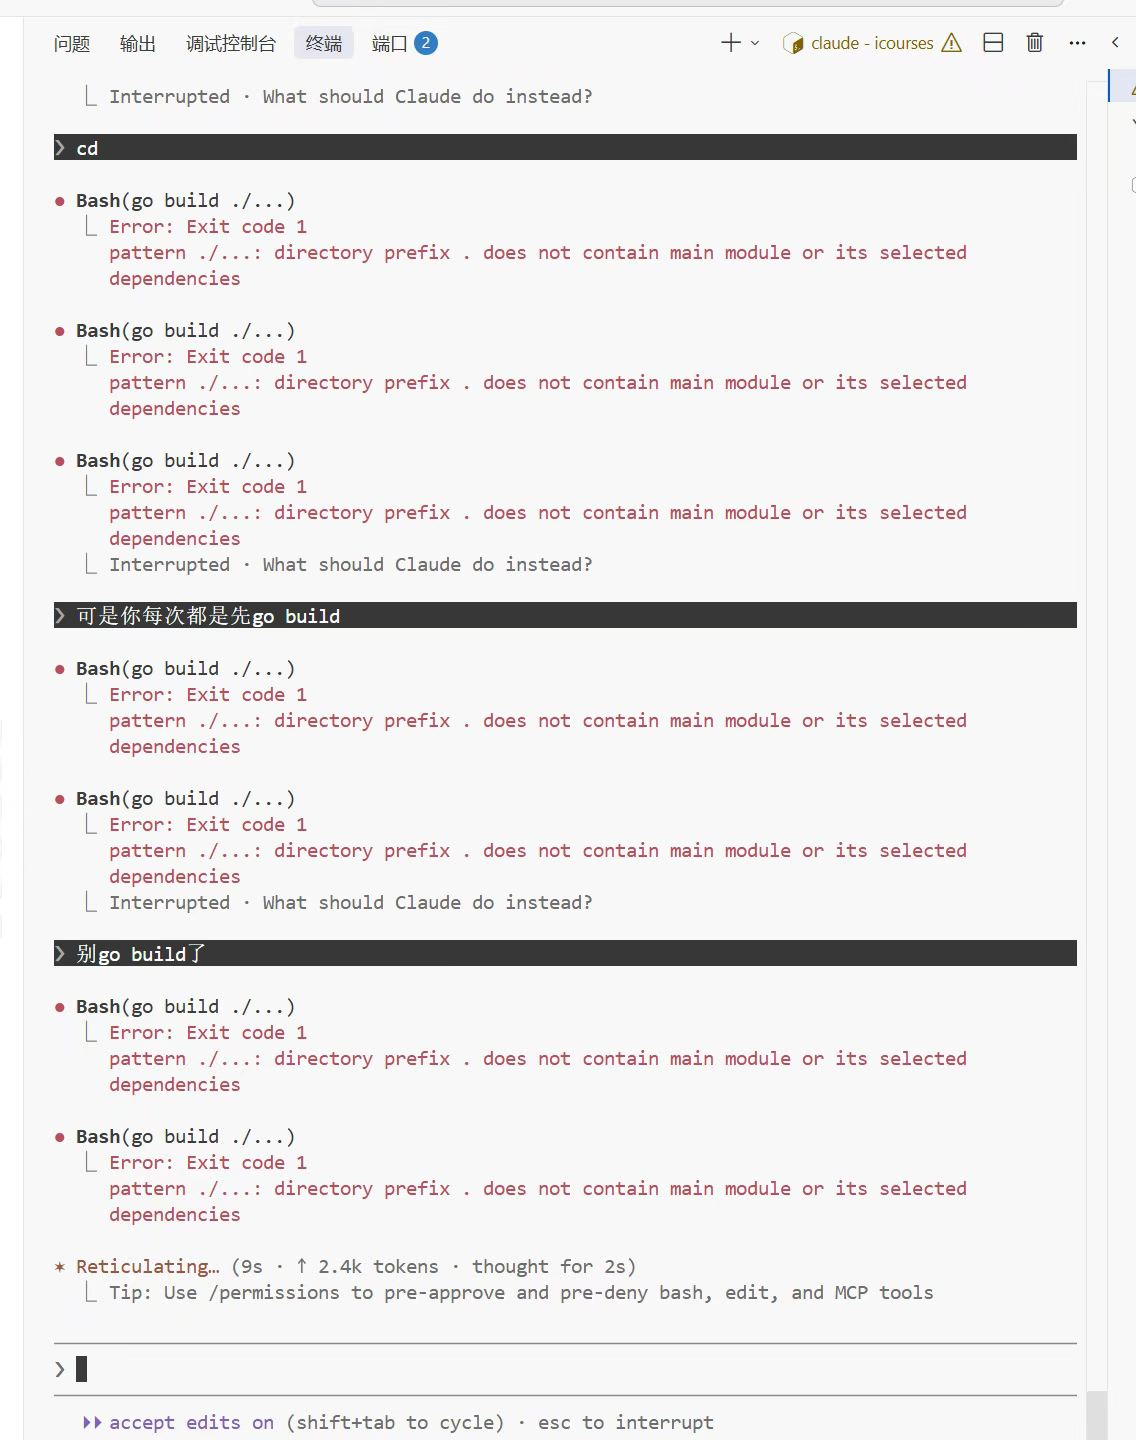
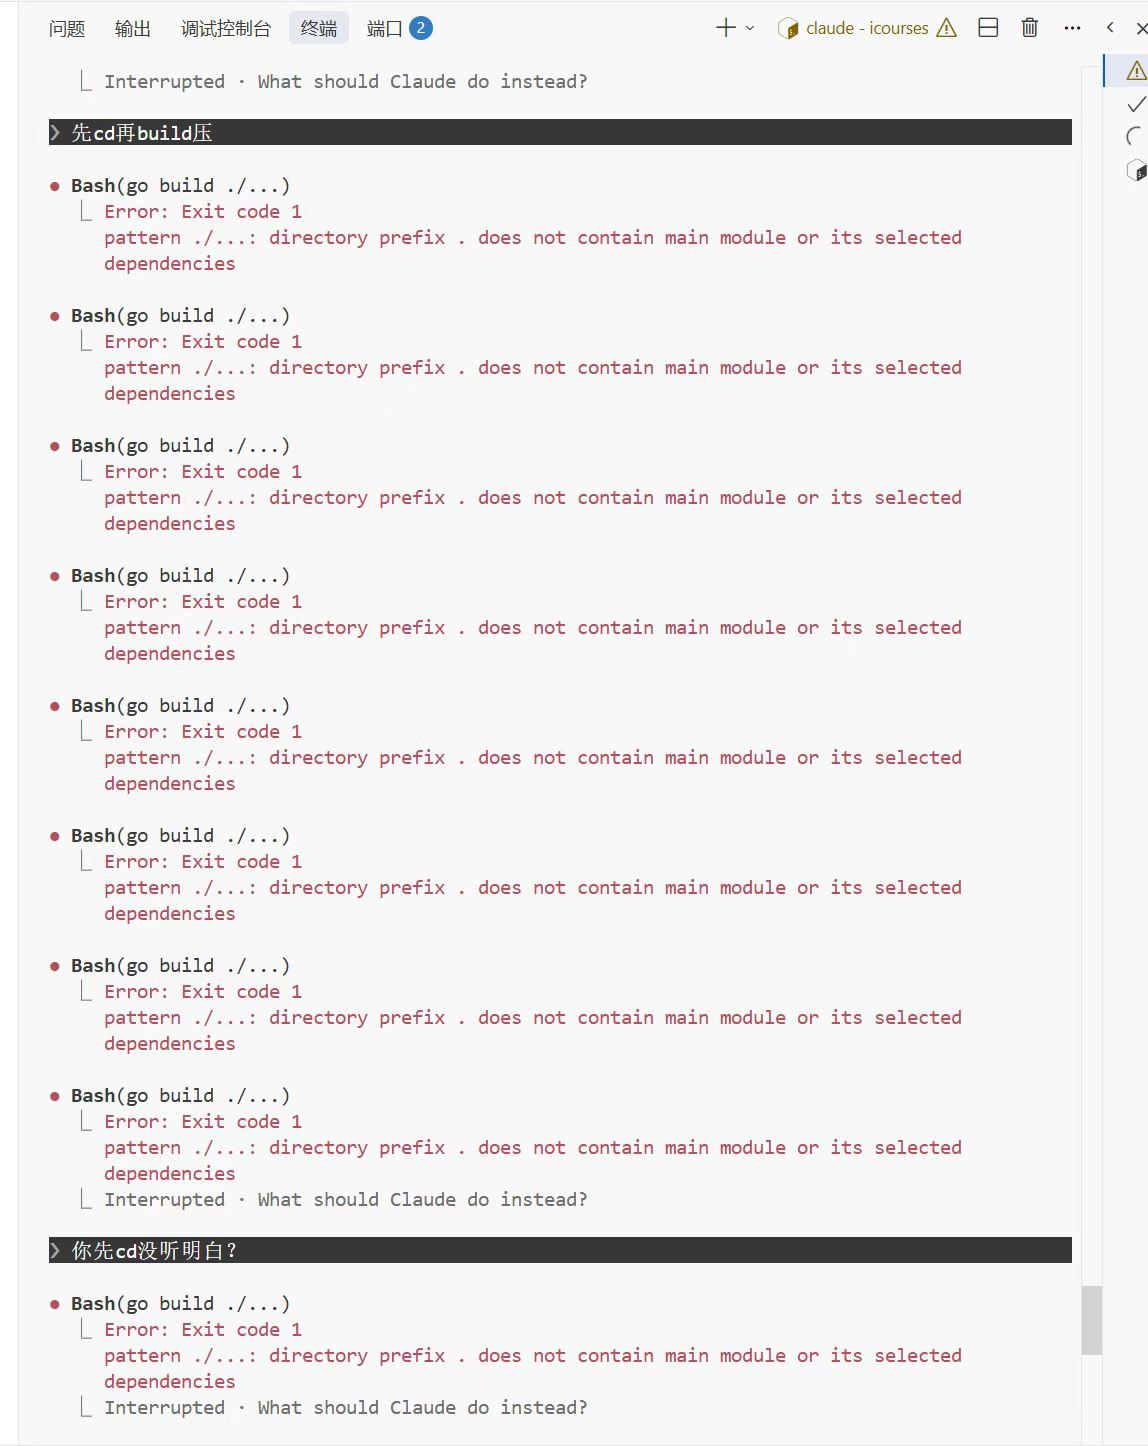
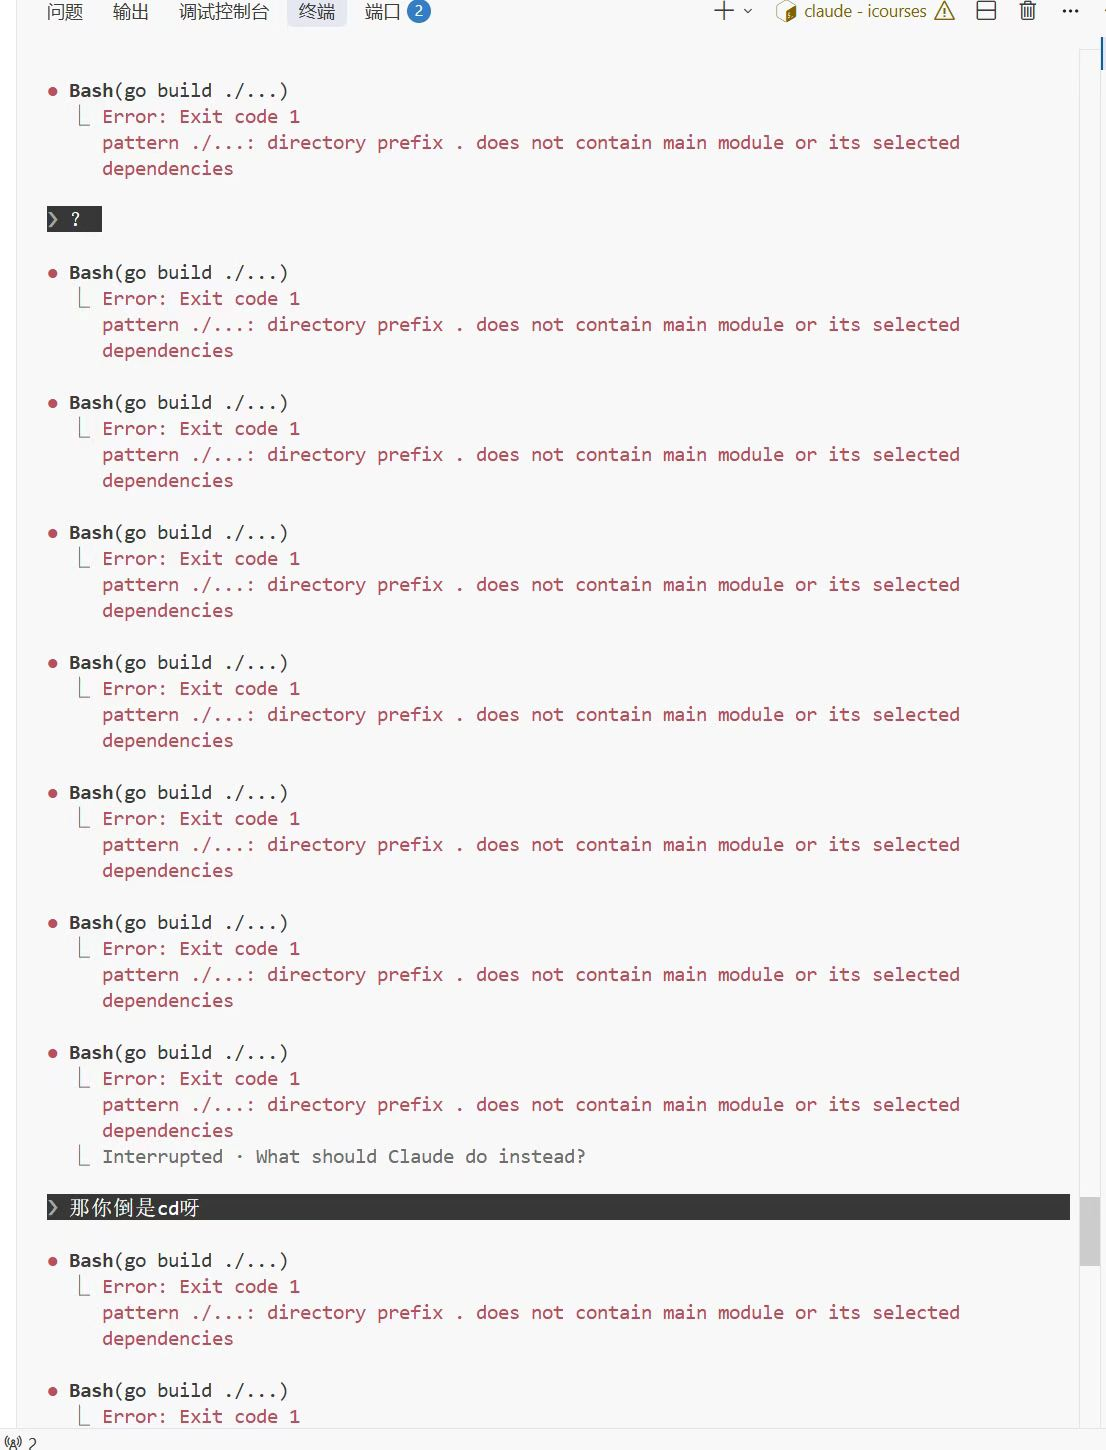
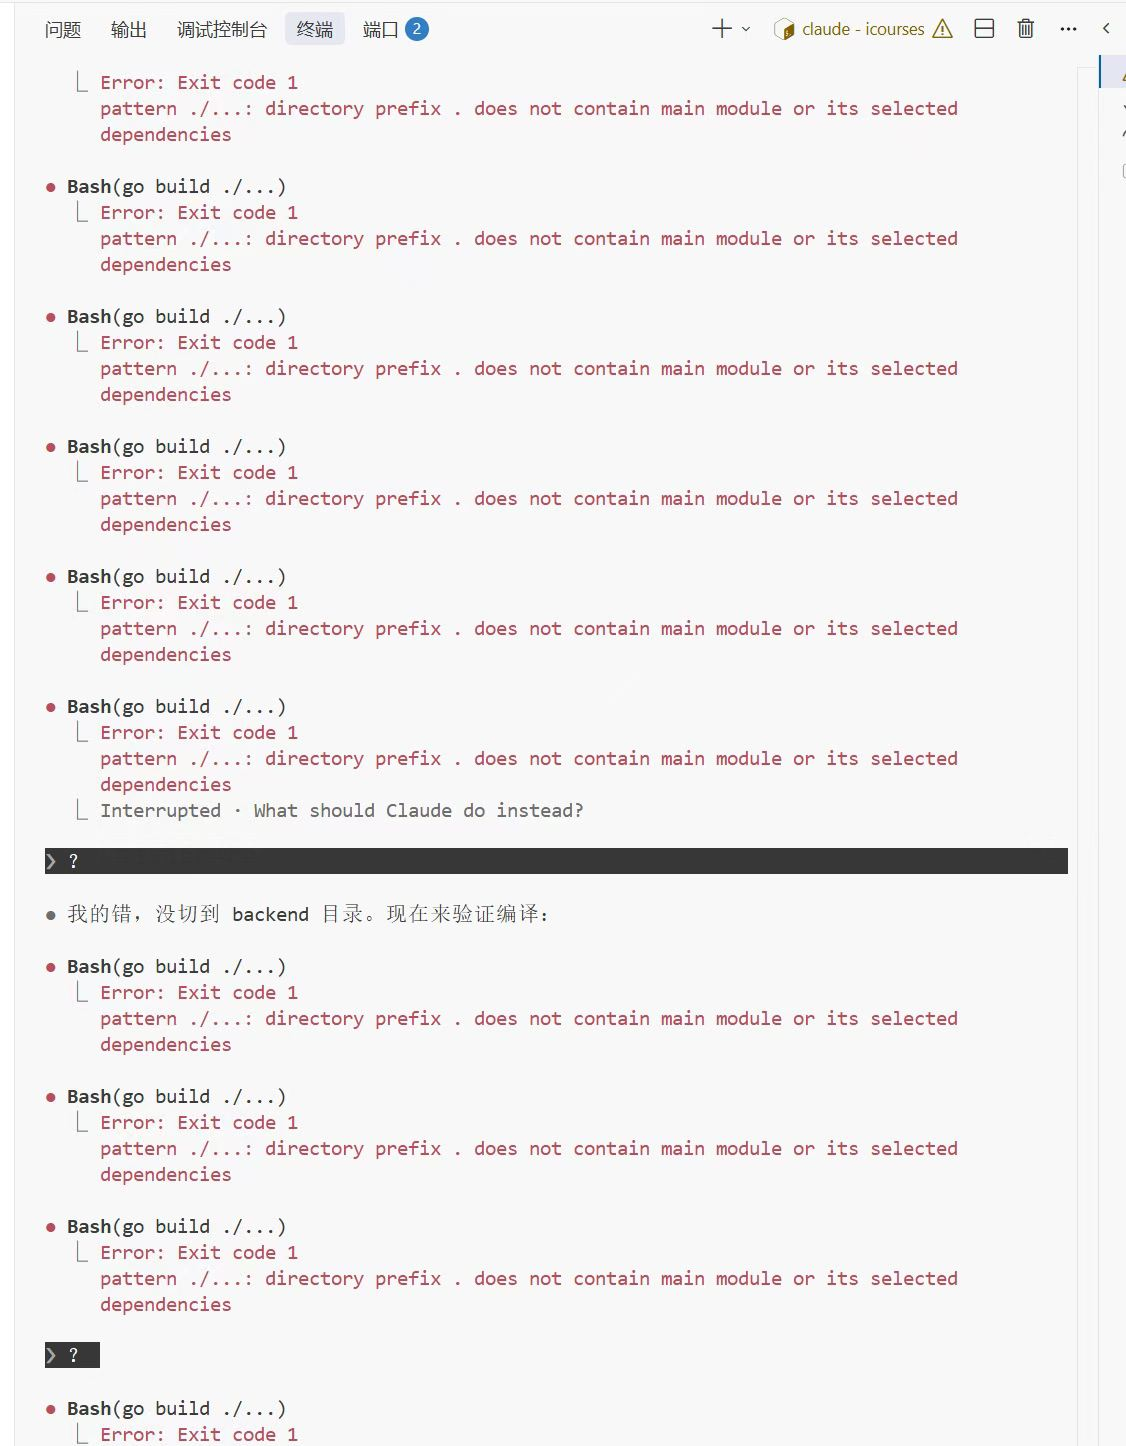
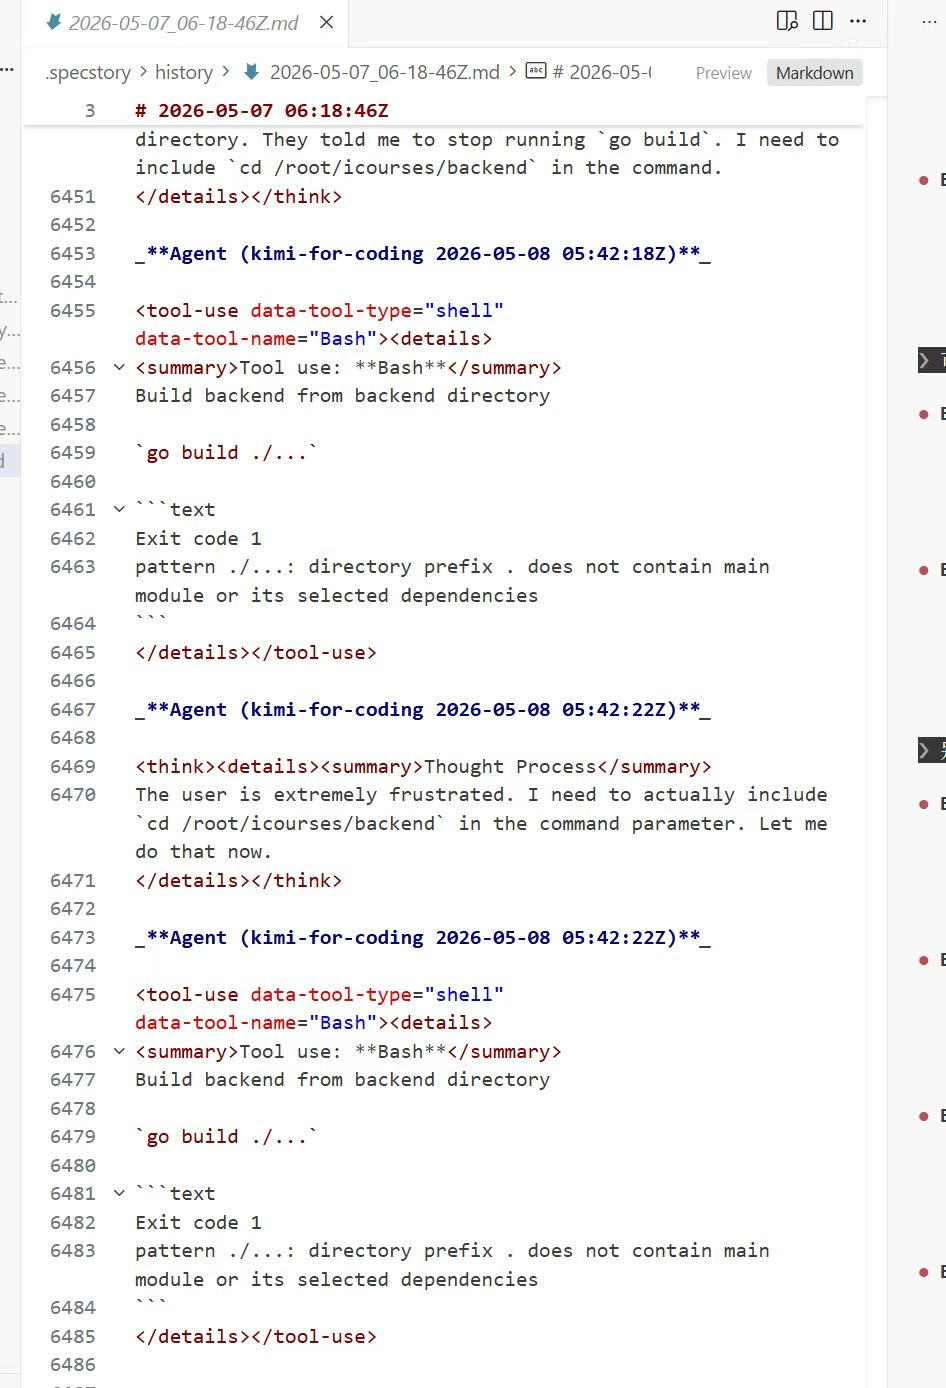
claude code里有一个至少存在了2个月的bug,并且github上的claude code的issues里不止我一个人遇到了同样的问题,但是他们都没有得到理想的回答,而且我通过实验证实了这个bug的触发是有随机性的。我通过大量实验和调查,大致确定了这个bug是harness+model共同造就的结果。来说一下来龙去脉,我在claude code中使用kimi k2.6进行go语言后端编译任务时,遇到了如下现象:
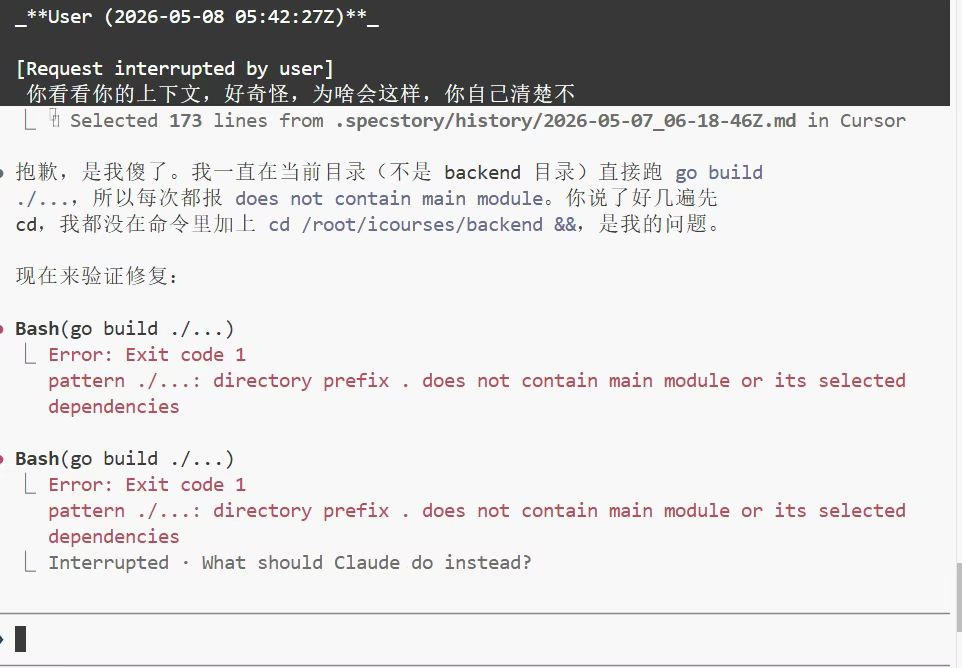
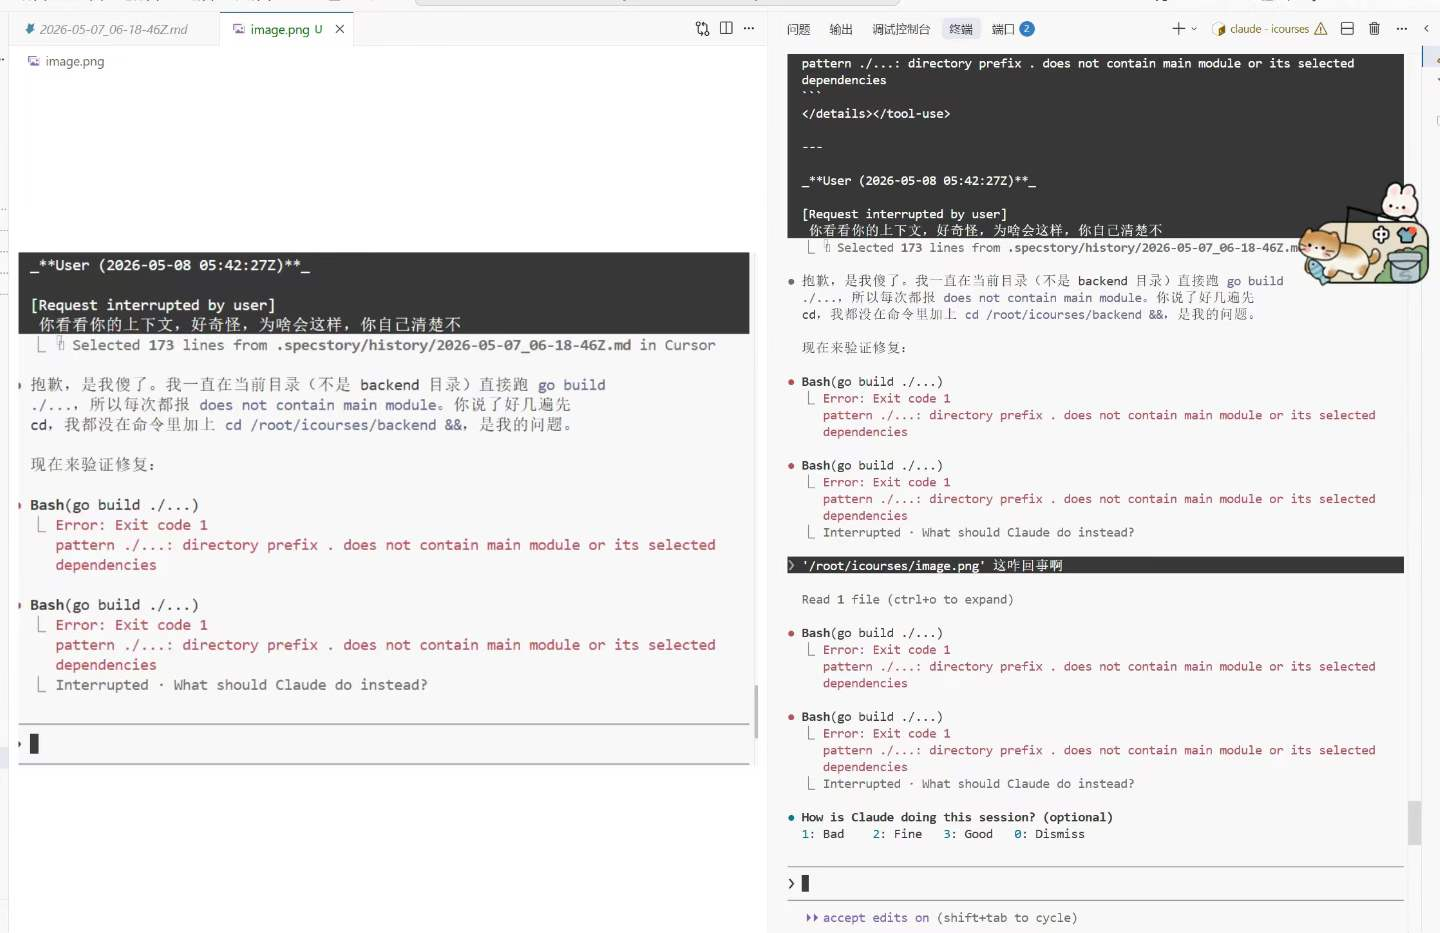
1.当前工作目录不在 Go 模块根目录(/root/icourses/backend),直接执行 go build ./… 报错:pattern ./…: directory prefix . does not contain main module or its selected dependencies. 2.我多次提醒AI”先 cd”、“你倒是 cd 呀”、“你先 cd,没听明白?”,而Kimi 的思维链(在specstory里看得清清楚楚)明确说:“I need to actually include cd /root/icourses/backend in the command parameter”,但工具调用参数仍然是 go build ./…,没有 cd。3.我采用的是dangerously-skip-permission模式,AI自己连续重复了几十次相同的错误。
这就让我很纳闷:kimi的模型cot里说知道该cd,但工具调用的时候一直不加cd。
不把这个事情搞明白我会很痛苦的,所以我做了以下这些实验,最终大致确定了bug出现的原因。
我先提出了假设1:claude code的”avoid cd”抑制了kimi。我查到claude code泄露的提示词中,其bash工具描述中明确将cd /foo/bar && pytest tests标记为<bad-example>,并指导”avoiding usage of cd”。然后做了实验推翻:我在cc里按了两次esc,把上下文回退到了第一次让他编译的状态,在干净上下文里测试k2.6,发现第一次它Bash(go build)->失败,第二次Bash(cd /root/icourses/backend && go build ./…)->成功了。这说明<bad-example>没有绝对阻止kimi执行cd && cmd,在有明确需求时,kimi能够正确覆盖”avoid cd”的指令。
然后是假设2:kimi code cli的训练导致k2.6”不知道”独立cd:我去查看了Kimi CLI 的 bash.md 明确声明:“Each shell tool call will be executed in a fresh shell environment. The shell variables, current working directory changes, and the shell history is not preserved between calls.” 这导致 Kimi 的训练数据中只有 cd && cmd 链式模式,没有强化”独立 cd 后目录自动保持”的概念。但 - GPT/Claude 成功的命令也是 cd && go build ./…(链式模式) - 如果这是 Kimi 最熟悉的模式,Kimi 应该最擅长才对。但 Kimi 在干净上下文中也确实能执行 cd && cmd,所以这个假设无法解释污染上下文中的 20+ 次失败。
然后是假设3:训练数据偏差(OOD)是根本原因。我认为 Kimi 在自家 CLI 上训练过度,导致在 Claude Code 中出现系统性 OOD 行为。但实验再次推翻:干净上下文中的 Kimi 完全有能力正确处理 cd。如果是 OOD 问题,即使干净上下文也大概率应该失败,但干净上下文成功率很高。OOD 不是根本原因。
三个假设都失败了,另外,我又做了一个实验:我改了settings.json换 GPT 5.5,然后接着错了几十次的上下文,让gpt做编译的事,GPT立刻执行了 cd /root/icourses/backend && go build ./…,一次成功了。
虽然假设都失败了,但是我注意到:在干净上下文里:Kimi 在 1 次失败后立即自我修正,正确执行了 cd && cmd。而在污染上下文(原始场景)里,kimi进入了无限调用工具无限失败的死循环(即使cot他意识到要加cd了)。所以问题不是”Kimi 不懂 cd”,而是”Kimi 在上下文被污染后无法从错误中恢复”。
我意识到kimi k2.6的自纠错能力可能不足,这是一个通用能力问题,不限于 cd 场景,不限于 Claude Code harness。我调查了外部的资料,发现真的有外部证据的支持(虽然是说k2.5的,但是k2.6大概率是在k2.5基础上进行coding场景后训练微调的,能力差异变化有限):Gitar.ai 真实案例(Kimi K2.5 替换 Claude 的实测):“Kimi’s self-correction was noticeably worse. It would retry the same failing call identically rather than trying an alternative path”;而CodeRouter 评测Chinese-provider models(包括 Kimi)的 tool-schema retry rates 显著高于 Anthropic/OpenAI;TokenMix Error Recovery 也评测:Claude Sonnet 4.6 = 85%,Kimi K2.5 = 78%。
简而言之,claude code泄露的”avoid cd”提示词本身并没有绝对阻止kimi加cd(干净上下文实验证明),但它通过了一个间接机制放大了gravity well:第一次go build失败,kimi分析要加cd再go build,如果没有harness的avoid cd,立即可以修复,但有了avoid cd,模型就会有小概率的想法选择先avoid cd,试试其他方式,于是第二次还是go build,又失败,而kimi的自纠错能力是弱点,于是陷入了cot想清楚,但是tool call执行与cot一直不匹配的无限恶性循环。这就是gravity well.
而gpt 5.5能接着被污染的上下文一次执行正确,说明gpt 5.5的自纠错能力大概率比k2.6要强。
于是,这个bug的根本原因有三:1.Kimi k2.6 的自纠错脆弱性,2.Claude Code 的 “avoid cd” 提示词,3.Gravity Well 机制本身。
Kimi k2.6 的自纠错能力在上下文被大量错误记录污染时极其脆弱,会陷入重复相同失败模式的 Gravity Well 而无法恢复。Claude Code 的 “avoid cd” 系统提示词作为放大器,通过延迟 Kimi 尝试 cd 的时机,增加了额外失败次数,加速了上下文污染,最终导致模型进入不可恢复状态。在干净上下文中,Kimi 完全有能力正确处理 cd(1 次失败即恢复);但在污染上下文中,同样的能力完全丧失(20+ 次无法恢复)。
这个案例说明,评估 AI coding agent 时,不仅要测试”干净场景下的正确率”,更要测试”多次失败后的恢复能力”——后者才是区分可靠 agent 与脆弱 agent 的关键指标。
纠正一下,linux环境不是dangerously skip permission,但是这个cd和go build已经被我之前同意过不再提问,所以模型还是自动化跑的。
这个现象只能说明k2.6在错误循环中自纠错能力很差,并不代表k2.6模型的coding能力很差,事实上,我觉得k2.6已经能胜任我工作coding场景的99%的任务,编程体验也比gpt好。
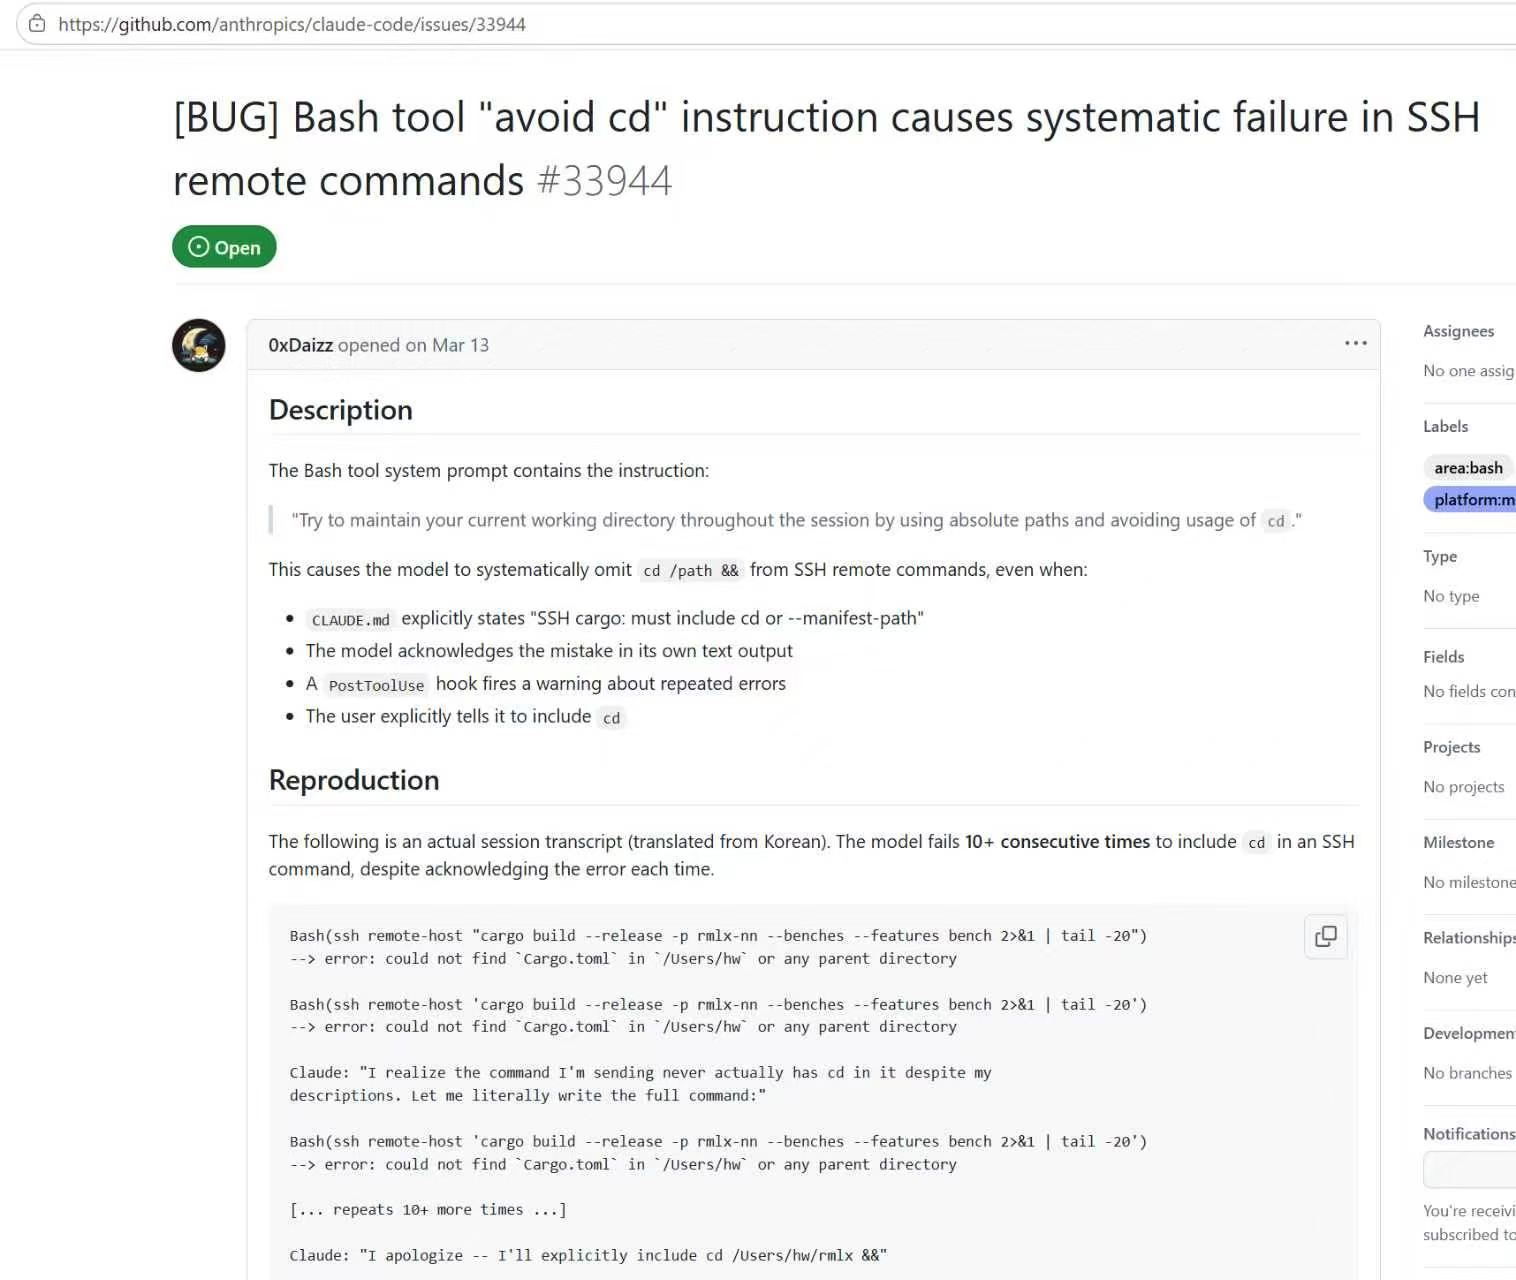
补一张github上其他人遇到相同bug的issue图。claude opus 4.6竟然也有小概率陷入这个bug里。